Blog
Όταν το cloud τίθεται εκτός λειτουργίας

Τι μας διδάσκει η διακοή λειτουργίας της Revolut για το Disaster Recovery και την Επιχειρησιακή Συνέχεια.
Το συμπέρασμα δεν είναι ότι οι υποδομές cloud είναι αναξιόπιστες. Είναι ότι η μετάβαση στο cloud δεν ισοδυναμεί με μια δοκιμασμένη στρατηγική Disaster Recovery και Επιχειρησιακής Συνέχειας.
Στις 20 Οκτωβρίου 2026, ένα περιστατικό που σχετιζόταν με την ηλεκτροδότηση επηρεάσε τη ζώνη διαθεσιμότητας europe-west2-b του Google Cloud στο Λονδίνο. Το συμβάν διέκοψε πολλές υπηρεσίες του Google Cloud, ενώ πελάτες της Revolut αντιμετώπισαν προβλήματα σε πληρωμές με κάρτα, αναλήψεις μετρητών και επιχειρηματικές υπηρεσίες. Η προτεινόμενη λύστη του Google Cloud ήταν η μεταφορά των επηρεαζόμενων φόρτων εργασίας σε άλλη ζώνη ή περιοχή, "όπου αυτό είναι εφικτό".
Αυτή η διατύπωση έχει σημασία. Η μεταφορά ενός σύνθετου παραγωγικού περιβάλλοντος κατά τη διάρκεια μιας ενεργής διακοπής είναι δύσκολη, επειδή οι εφαρμογές συνήθως εξαρτώνται από βάσεις δεδομένων, υπηρεσίες ταυτότητας, δίκτυα, αποθηκευτικούς πόρους και διασυνδέσεις τρίτων. Η διαδικασία ανάκαμψης δεν πρέπει να σχεδιάζεται όταν η επιχείρηση βρίσκεται ήδη εκτός λειτουργίας.
Το σχέδιο Disaster Recovery πρέπει να είναι έτοιμο για εφαρμογή
Υπάρχει ουσιαστική διαφορά ανάμεσα στο "μπορούμς να ανακατασκευάσουμε ή να μεταφέρουμε το περιβάλλον μας αλλού" και στο να διαθέτουμε ήδη αναπαραγόμενους φόρτους εργασίας, συμφωνημένες προτεραιότητες ανάκαμψης, χαρτογραφημένες εξαρτήσεις και δοκιμασμένες διακοπές failover.
Ένα αξιόπιστο σχέδιο Disaster Recovery πρέπει να ορίζει ποιες υπηρεσίες αποκαθίστανται πρώτες, ποιος έχει την αρμοδιότητα να κηρύξει κατάσταση καταστροφής, πώς επανασυνδέονται οι χρήστες και οι πελάτες, πώς επαληθεύεται η ακεραιότητα των δεδομένων και πώς οι λειτουργίες επιστρέφουν με ασφάλεια στο κύριο περιβάλλον.
Πώς το Azure Site Recovery ενισχύει το Disaster Recovery
Το Microsoft Azure Site Recovery (ASR) υποστηρίζει την Επιχειρησιακή Συνέχεια και το Disaster Recovery. Σύμφωνα με τη Microsoft, το ASR μπορεί να αναπαράγει εικονικές μηχανές Azure σε μια δευτερεύουσα περοχή και να ενορχηστρώνει την αναπαραγωγή, το failover και την ανάκαμψη. Κατά το failover, δημιουργούνται εικονικές μηχανές-στόχοι από τα αναπαραγόμενα σημεία ανάκαμψης στη δευτερεύουσα περιοχή.
Με αυτόν τον τρόπο περιορίζονται σημαντικά οι εργασίες που απαιτούνται κατά τη διάρκεια μιας διακοπής, καθώς η αναπαραγωγή και η διαδικασία ανάκαμψης έχουν ρυθμιστεί εκ των προτέρων. Η Microsoft συνιστά επίσης τακτικές ασκήσεις Disaster Recovery, ώστε οι οργανισμοί να επαληθεύουν τη διαμόρφωση χωρίς να επηρεάζουν τους παραγωγικούς φόρτους εργασίας.
Σημαντική τεχνική διευκρίνηση: Το ASR δεν πρέπει να παρουσιάζεται ως ένα πλήρες, μόνιμα ενεργό αντίγραφο κάθε υπηρεσίας Azure. Παρέχει αναπαραγόμενα δεδομένα ανάκαμψης και ενορχηστρωμένο failover για τους υποστηριζόμενους φόρτους εργασίας. Οι εφαρμογές που απαιτούν σχεδόν μηδενικό χρόνο διακοπής ενδέχεται να χρειάζονται επίσης σχεδιασμό active-active, αναπαραγωγή βάσεων δεδομένων, ανθεκτικές υπηρεσίες ταυτότητας, δικτυακό failover και γεωγραφικά κατανεμημένα στοιχεία εφαρμογών.
Για κρίσιμες πλατφόρμες, προτεραιότητα στην αρχιτεκτονική active-active
Για πλατφόρμες αδιάλειπτης λειτουργίας και υψηλού όγκου συναλλαγών, όπως η Revolut, πρέπει να εξετάζεται αρχιτεκτονική active-active για τις κρισιμότερες εφαρμογές και υπηρεσίες δεδομένων. Σε αυτό το μοντέλο, δύο ή περισσότερα περιβάλλοντα λειτουργούν ταυτόχρονα και εξυπηρετούν την παραγωγική κίνηση. Αν μια τοποθεσία, ζώνη ή περιοχή τεθεί εκτός λειτουργίας, η κίνηση μπορεί να ανακατευθυνθεί σε άλλο ενεργό περιβάλλον, χωρίς αναμονή για τη δημιουργία υποδομών ή την αποκατάσταση εφαρμογών.
Το επίπεδο δεδομένων είναι το σημαντικότερο στοιχείο αυτού του σχεδιασμού. Οι βάσεις δεδομένων, η επεξεργασία συναλλαγών, οι υπηρεσίες ταυτότητας, τα συστήματα ανταλλαγής μηνυμάτων και ι δικτυακές υπηρεσίες πρέπει να έχουν σχεδιαστεί για διαθεσιμότητα μεταξύ περιοχών, συνέπεια δεδομένων και ελεγχόμενο failover. Στόχος είναι να ελαχιστοποιηθούν τόσο η διακοπή υπηρεσιών όσο και ο κίνδυνος απώλειας ολοκληρωμένων συναλλαγών. Ωστόσο, το εφικτό RPO εξαρτάται από τη μέθοδο αναπαραγωγής και το επιλεγμένο μοντέλο συνέπειας.
Η αρχιτεκτονική active-active δεν αντικαθιστά το Disaster Recovery.
Προστατεύει από πολλές αστοχίες υποδομής και περιοχής, αλλά ενδέχεται να μην καλύπτει αλλοίωση δεδομένων, σφάλματα λογισμικού, κυβερνοεπιθέσεις, παραβίαση διαπιστευτηρίων, λανθασμένες ρυθμίσεις ή ένα ευρύτερο συμβάν στον πάροχο. Πάνω από την παραγωγική αρχτιεκτονική active-active πρέπει, επομένως, να υπάρχει ξεχωριστή και δοκιμασμένη δυνατότητα Disaster Recovery, με απομονωμένα αντίγραφα ανάκαμψης, καθορισμένα σημεία επαναφοράς, τεκμηριωμένα runbooks και τακτικές ασκήσεις από άκρο σε άκρο.
Για έναν οργανισμοό όπως η Revolut, το ισχυρότερο μοντέλο ανθεκτικότητας είναι πολυεπίπεδο: αρχιτεκτονική active-active για άμεση συνέχεια των υπηρεσιών και ξεχωριστό περιβάλλον Disaster Recovery για ανάκαμψη από σοβαρά ή συστημικά συμβάντα.
Ένα βήμα παραπέρα: Disaster Recovery σε δεύτερο πάροχο cloud
Η γεωγραφική πλεονασματικότητα προστατεύει από πολλές αστοχίες, αλλά δεν εξαλείφει πλήρως τον κίνδυνο συγκέντρωσης σε έναν πάροχο cloud. Για οργανισμούς στους οποίους η διακοπή λειτουργίας έχει σοβαρό οικονομικό, επιχειρησιακό, κανονιστικό αντίκτυπο ή πλήττει τη φήμη τους, μπορεί να είναι σκόπιμη η φιλοξενία του περιβάλλοντος Disaster Recovery σε διαφορετικό πάροχο cloud.
Για παράδειγμα, μια επιχείρηση με κύριο περιβάλλον το Microsoft Azure θα μπορούσε να διατηρεί επιλεγμένες δυνατότητες ανάκαμψης στο Amazon Web Services ή στο Google Cloud- και το αντίστροφο. Έτσι, το παραγωγικό περιβάλλον και η μοναδική επιλογή ανάκαμψης δεν βρίσκονται στο ίδιο πεδίο αστοχίας του παρόχου.
Το multi-cloud Disaster Recovery δεν αποτελεί αυτομάτως την καλύτερη λύση για κάθε οργανισμό. Μπορεί να αυξήσει το κόστος και την πολυπλοκότητα στη διαχείριση ταυτοτήτων, στα δίκτυα, στους ελέγχους ασφάλειας, στην αδειοδότηση, στην αναπαραγωγή δεδομένων, στον αυτοματισμό, στην παρακολούθηση και στις απαιτούμενες δεξιότητες υποστήριξης. Η σωστή απόφαση εξαρτάται από τον επιχειρηματικό αντίκτυπο της διακοπής και τους απαιτούμενους στόχους Recovery Time Objective (RTO) και Recovery Point Objective (RPO).
Σενάρια Disaster Recovery ανά στόχο χρόνου ανάκαμψης (RTO)
Οι παρακάτω αρχιτεκτονικές αναφοράς παρουσιάζουν τρία συνήθη επίπεδα επιχειρησιακής ανθεκτικότητας. Η κατάλληλη λύση εξαρτάται από τις εξαρτήσεις των εφαρμογών, τις απαιτήσεις συνέπειας των δεδομένων, την αποδεκτή απώλεια δεδομένων, τον προϋπολογισμό και την επιχειρησιακή ετοιμότητα. Το "RTO 0 ωρών" πρέπει να αντιμετωπίζεται ως στόχος σχεδόν μηδενικής διακοπής και όχι ως απόλυτη εγγύηση.
Σενάριο 1: RTO έως 4 ώρες- Disaster Recovery μεταξύ περιοχών
Κατάλληλο όταν η επιχείρηση μπορεί να ανεχθεί ένα ελεγχόμενο χρονικό διάστημα ανάκαμψης. Η παραγωγή λειτουργεί στην κύρια περιοχή, ενώ τα δεδομένα των εφαρμογών και τα στοιχεία ανάκαμψης αναπαράγονται σε μια δευτερεύουσα περιοχή. Το failover ακολουθεί ένα τεκμηριωμένο και τακτικά δοκιμασμένο runbook.
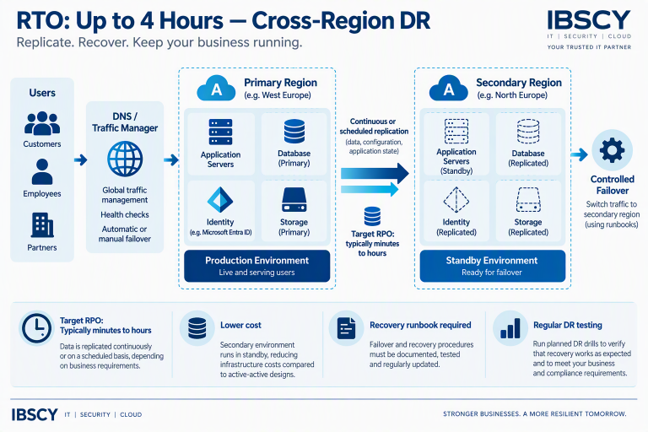
Αρχιτεκτονική αναφοράς. Οι τελικοί στόχοι RTO και RPO εξαρτώνται από τον συνολικό σχεδιασμό της λύσης, τις δοκιμές και τις διαδικασίες λειτουργίας.
Σενάριο 2: RTO έως 2 ώρες- Disaster Recovery με warm standby
Κατάλληλο για πιο κρίσιμες υπηρεσίες. Η βασική υποδομή έχει ήδη εγκατασταθεί στη δευτερεύουσα περιοχή με μειωμένη δυναμικότητα, ενώ η αναπαραγωγή, η παρακολούθηση και τον ενορχηστωμένο failover έχουν σχεδιαστεί ώστε να περιορίζουν τον χώρο ανάκαμψης.
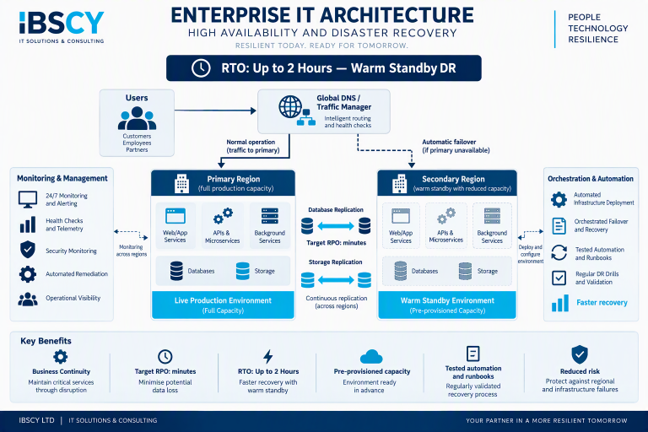
Αρχιτεκτονική αναφοράς. Οι τελικοί στόχοι RTO και RPO εξαρτώνται από τον συνολικό σχεδιασμό της λύσης, τις δοκιμές και τις διαδικασίες λειτουργίας.
Σενάριο 3: Σχεδόν μηδενικό RTO- Active-active με ξεχωριστό Disaster Recovery
Κατάλληλο για αδιάλειπτες υπηρεσίες υψηλού όγκου συναλλαγών. Δύο παραγωγικές περιοχές λειτουργούν ταυτόχρονα, με παγκόσμια κατανομή κίνησης και ειδικά σχεδιασμένο μοντέλο συνέπειας δεδομένων.
Παραμένει απαραίτητο ένα ξεχωριστό, απομονωμένο επίπεδο Disaster Recovery για περιπτώσεις αλλοίωσης δεδομένων, κυβερνοεπίθεσης, λανθασμένης διαμόρφωσης ή ευρύτερου συστημικού συμβάντος.
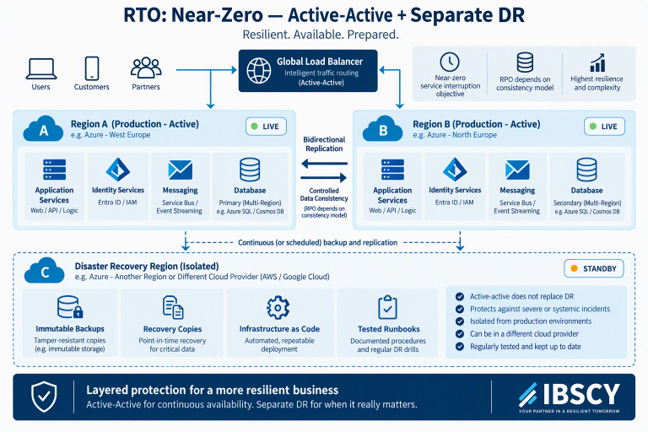
Αρχιτεκτονική αναφοράς. Οι τελικοί στόχοι RTO και RPO εξαρτώνται από τον συνολικό σχεδιασμό της λύσης, τις δοκιμές και τις διαδικασίες λειτουργίας.
Το backup δεν είναι Disaster Recovery
Το υλικό DisasterProof της IBSCY κάνει μια σαφή διάκριση: το backup αφορά τα αντίγραφα αρχείων και δεδομένων, ενώ το Disaster Recovery καλύπτει την ολοκληρωμένη στρατηγική αντιμετώπισης ενός συμβάντος. Περιλαμβάνει τεχνολογία, αρμοδιότητες, προτεραιότητες αποκατάστασης, στόχους RTO και RPO, δοκιμές και επαλήθευση.
Μια εταιρεία μπορεί να διαθέτει επιτυχημένα αντίγραφα ασφαλείας και, παρ'όλα αυτά, να παραμείνει εκτός λειτουργίας για ώρες ή μέρες. Το backup είναι απαραίτητο, αλλά από μόνο του δεν εξασφαλίζει διαθεσιμότητα εφαρμογών, δικτυακή συνδεσιμότητα, υπηρεσίες ταυτότητας, συντονισμό ανάκαμψης ή δοκιμασμένη διαδικασία επαναφοράς των επιχειρησιακών λειτουργιών.
Checklist ετοιμότητας για Επιχειρησιακή Συνέχεια και Disaster Recovery
| Τομέας | Ερώτηση που πρέπει να απαντηθεί |
| Κρίσιμες υπηρεσίες | Ποιές εφαρμογές. συστήματα και επιχειρηματικές διαδικασίες πρέπει να αποκατασταθούν πρώτα; |
| RPO | Πόσα δεδομένα μπορεί να αντέξει να χάσει ο οργανισμός; |
| RTO | Για πόσο χρόνο μπορεί κάθε κρίσιμη υπηρεσία να παραμείνει μη διαθέσιμη; |
| Εξαρτήσεις | Ποιες βάσεις δεδομένων, υπηρεσίες ταυτότητας, δίκτυα, πλατφόρμες αποθήκευσης και διασυνδέσεις απαιτούνται; |
| Αρμοδιότητα |
Ποιος μπορεί να κηρύξει καταστροφή και να ενεργοποιήσει το failover; |
| Επικοινωνία | Πώς θα ενημερωθούν εργαζόμενοι, πελάτες, συνεργάτες και ρυθμιστικές αρχές; |
| Δοκιμές | Πότε δοκιμάστηκε για τελευταία φορά η διαδικασία ανάκαμψης από άκρο σε άκρο; |
Λύσεις Business Continuity και Disaster Recovery από την IBSCY
- Αξιολόγηση Επιχειρηματικού Αντικτύπου και Disaster Recovery: Εντοπίζουμε τις κρίσιμες υπηρεσίες, τις εξαρτήσεις και τον αποδεκτό χρόνο διακοπής και καθορίζουμε ρεαλιστικούς στόχους RTO και RPO.
- Active-active και αρχιτεκτονική υψηλής διαθεσιμότητας: Σχεδιάζουμε εφαρμογές, βάσεις δεδομένων, υπηρεσίες ταυτότητας και δίκτυα σε πολλαπλές ζώνες ή περιοχές για κρίσιμες υπηρεσίες που απαιτούν ελάχιστο χρόνο διακοπής και περιορισμένη απώλεια δεδομένων.
- Cross-region Disaster Recovery στο Azure: Σχεδιάζουμε την αναπαραγωγή και το failover για κατάλληλους φόρτους εργασίας Azure και on-premises, με το Azure Site Recovery και άλλες υποστηρικτικές υπηρεσίες Azure.
- Hybrid και multi-cloud Disaster Recovery: Αξιολογούμε ποιο μοντέλο- δευτερεύουσα περιοχή Azure, άλλος πάροχος cloud, on-premises πλατφόρμα ανάκαμψης ή υβριδικής λύση- προσφέρει την κατάλληλη ισορροπία ανεξαρτησίας, κόστους και πολυπλοκότητας.
- Backup και προστασία εκτός εγκαταστάσεων: Υλοποιούμε αντίγραφα ασφαλείας ως ξεχωριστό επίπεδο προστασίας, με κατάλληλους χρόνους διατήρησης, αντίγραφα εκτός εγκαταστάσεων και τακτική επαλήθευση της επαναφοράς.
- Runbooks, ρόλοι και επικοινωνία: Τεκμηριώνουμε αρμοδιότητες, διαδρομές κλιμάκωσης, βήματα failover, ελέγχους επικύρωσης και επικοινωνία με όλα τα ενδιαφερόμενα μέρη.
- Δοκιμές Disaster Recovery και συνεχής βελτίωση: Πραγματοποιούμε προγραμματισμένες ασκήσεις ανάκαμψης, καταγράφουμε τα αποτελέσματα και καλύπτουμε τα κενά πριν από ένα πραγματικό συμβάν.
Το πραγματικό ερώτημα δεν είναι αν θα συμβεί μια διακοπή
Η Google, η Microsoft, η Amazon , ένα τοπικό κέντρο δεδομένων, ένας πάροχος τηλεπικοινωνιών ή μια on-premises υποδομή μπορούν να αντιμετωπίσουν διακοπή λειτουργίας. Καμιά υποδομή δεν πρέπει να θεωρείται απροσβλητη από αστοχίες.
Το ουσιαστικό ερώτημα είναι: " Αν η υποδομή που φιλοξενεί τα σημαντικότερα συστήματα μας τεθεί εκτός λειτουργίας αύριο τοπρωί, πόσο γρήγορα μπορούμε να συνεχίσουμε να λειτουργούμε;"
|
Μην περιμένετε την επόμενη διακοπή για να διαπιστώσετε αν λειτουργεί το σχέδιο Μιλήστε με την IBSCY για μια λύση Επιχειρησιακής Συνέχειας και Disaster Recovery- cross region, hybrid ή multi-cloud- σχεδιασμένη με βάση τον αποδεκτό χρόνο διακοπής της επιχείρησής σας. |
Πηγές
- Αναφορά για τη διακοπή του Google Cloud και τον αντίκτυπο στη Revolut, 20 Οκτωβρίου 2026
- Ανάλυση της διακοπής του Google Cloud στο Λονδίνο που επηρέασε τη Revolut
- Microsoft Learn: Failover εικονικών μηχανών Azure σε δευτερεύουσα περιοχή
- Microsoft Learn: Ρύθμιση Disaster Recovery για εικονικές μηχανές Azure σε δευτερεύουσα περιοχή
- IBSCYDisasterProof: Παρουσίαση Επιχειρησιακής Συνέχειας — εσωτερική πηγή IBSCY
